World Model
World Models
Meta
- Author:David Ha
- Conference:NeurIPS 2018
- Link:World Models
Intro
- 理解大脑内部预测模型的一种方式认为:它或许不只是泛泛地预测未来,而是在给定当前运动动作的条件下预测未来的感官数据
- RNN-based world models + controllers
Method
framework:

VAE (V) Model

MDN-RNN (M) Model
(RNN with a Mixture Density Network output layer)

Controller (C) Model

All in All

Experiments
- CarRacing-v0: World Model for Feature Extraction
- VizDoom Take Cover: Learning Inside of a Dream
DreamerV3
Meta
- Author:Google DeepMind
- Conference:Nature
- Link:Dreamer V3
Method
Framework

World model learning
- Recurrent State-Space Model

- loss

- Recurrent State-Space Model
Critic learning


Actor learning


Robust predictions
- symlog 变换 + symlog 平方损失
- symexp 双热编码损失(twohot loss)
Genie
Meta
- Author:Google DeepMind
- Conference:ICML 2024
- Link:Genie
Method
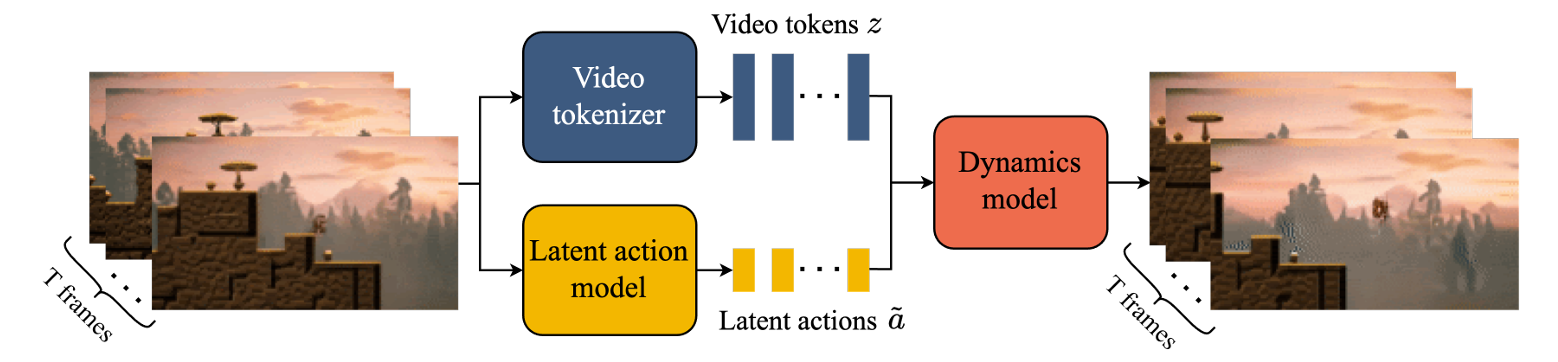
三个关键组件:
1)潜在动作模型,用于推断每对帧之间的潜在动作a;
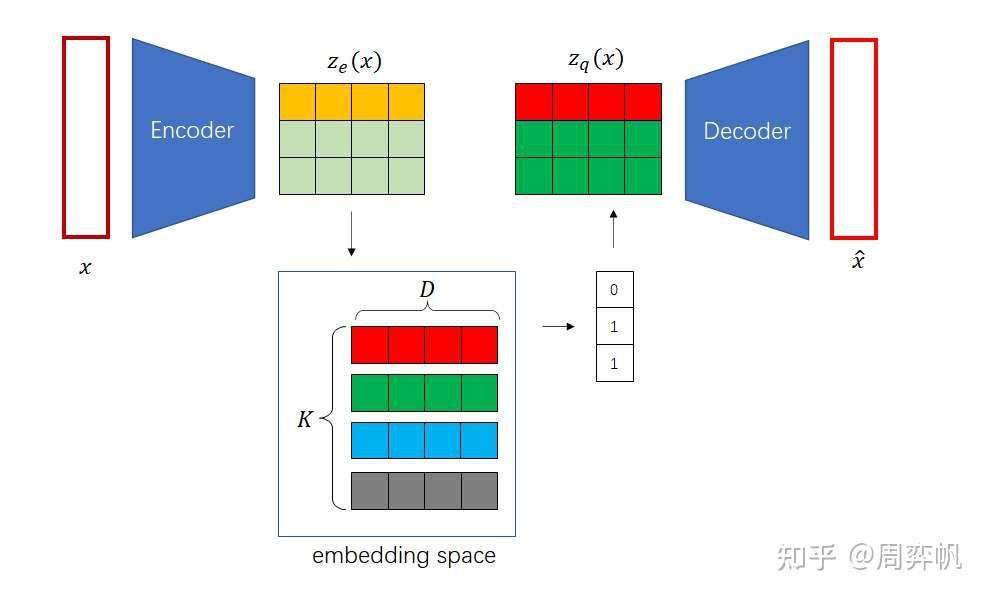
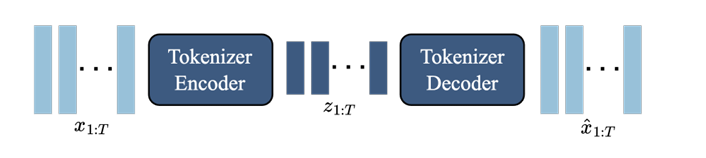
2)视频分词器,用于将原始视频帧转换为离散token z;
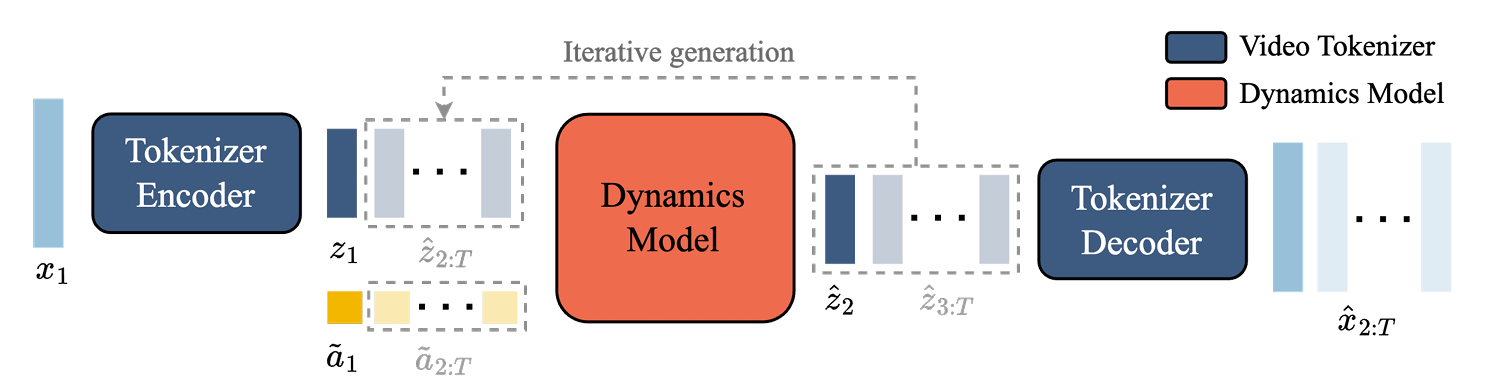
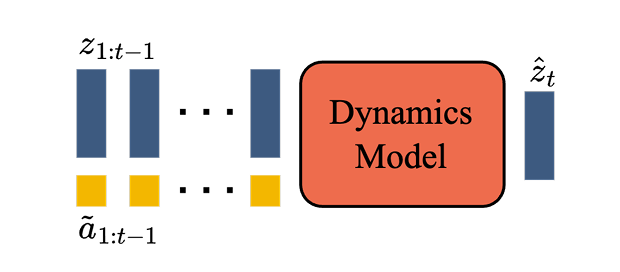
3)动态模型,在给定潜在动作和过去帧token的情况下,预测视频的下一帧。该模型遵循标准自回归视频生成流程分两阶段训练:我们首先训练视频分词器,该分词器将用于动态模型。然后我们共同训练潜在动作模型(直接从像素级数据训练)和动态模型(在视频token上训练)。
Latent Action Model (LAM):
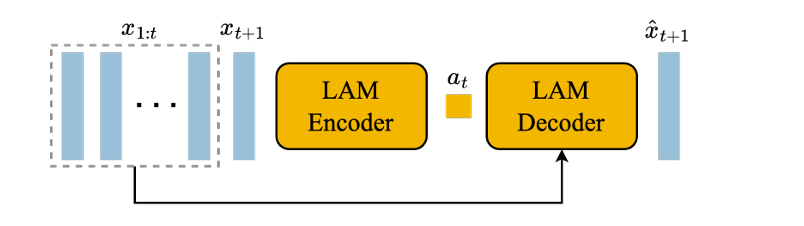
- VQ-VAE —— Train codebook
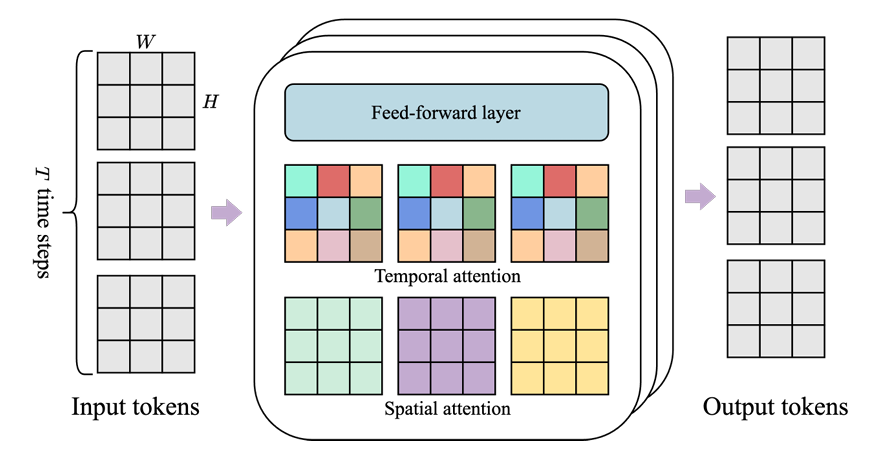
- ST-Transformer
- VQ-VAE —— Train codebook
Video Tokenizer
Inference: Action-Controllable Video Generation
JEPA
IJEPA
- Author:Yann LeCun
- Conference:CVPR 2023
- Link:IJEPA
Method
I-JEPA 背后的思想是在抽象表示空间中预测缺失信息
现有的生成式和非生成式自监督学习方法确实都可以纳入Energy-Based Models (EBMs)框架
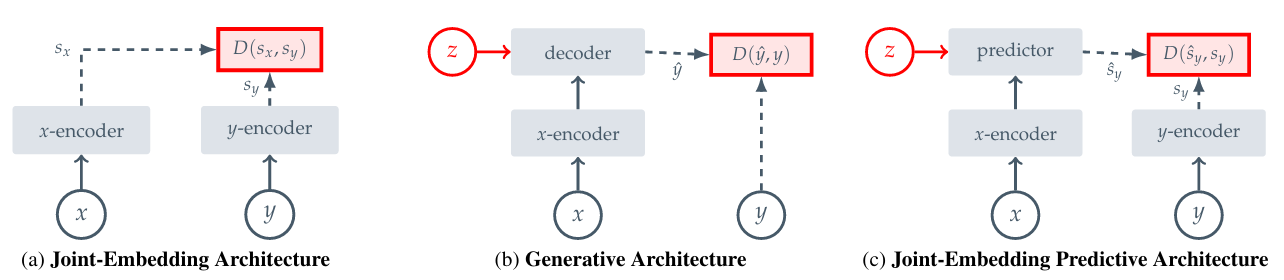
- 与联合嵌入架构一样,表示坍塌也是 JEPA 面临的一个问题;我们利用 x 编码器和 y 编码器之间的非对称架构来避免表示坍塌
Framework
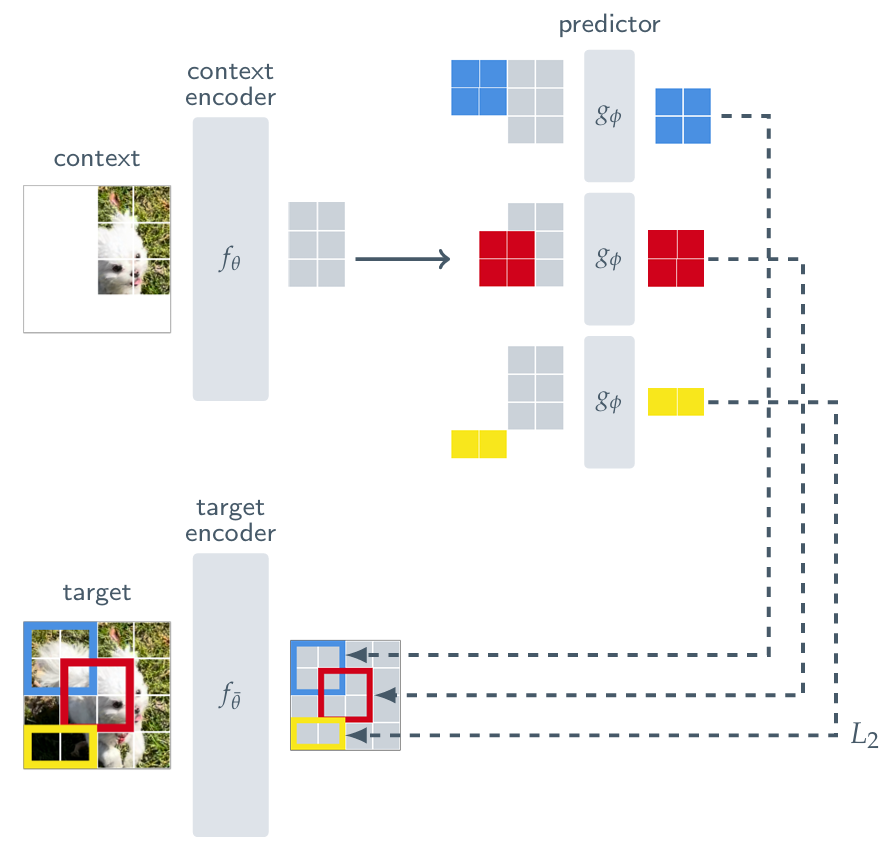
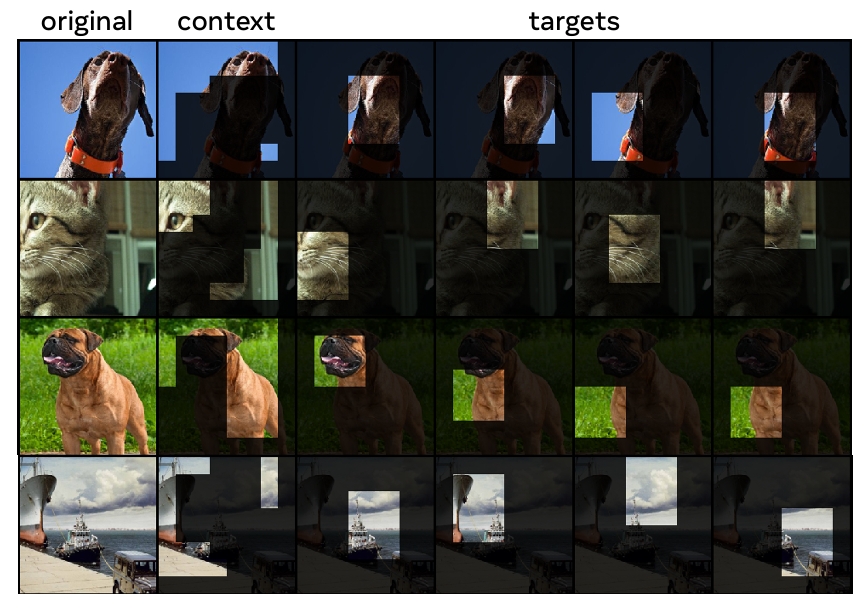
Loss
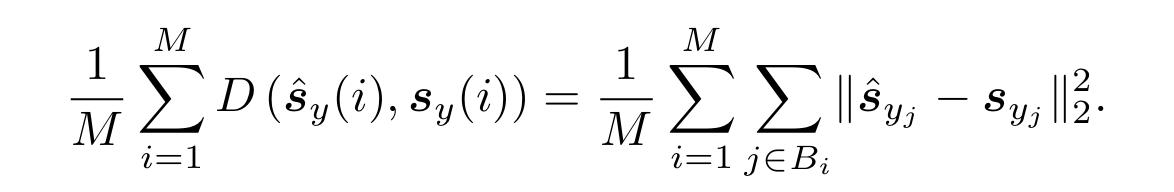
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 小鱼日记!